Xgboost模型
-
案例数据下载 下载
在机器学习应用中,Xgboost模型作为一种集成算法,其在数据量较大时表现较出色,并且有着较高的准确性,以及其具有一定的可解释性,可提供各特征项的重要性评估指标,而且xgboost模型时可加入正则项,有效地控制过拟合问题。Xgboost当前在各个领域有着较为广泛的应用,与其它的机器学习算法类似,其通常也用于分类和预测数据,当然也可使用其进行特征选择等。
Xgboost模型案例
-
1、背景
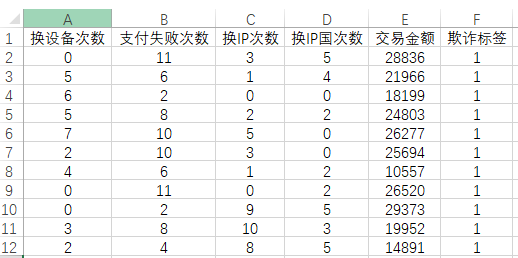
当前有一项关于‘信用卡交易欺诈’的数据科学研究,已整理好数据共为1000条,其包括六项,分别是换设备次数,支付失败次数,换IP次数,换IP国家次数,交易金额和欺诈标签,欺诈标签时,数字1表示欺诈,数字0表示没有欺诈行为,现希望通过xgboost进行模型构建,并且做一些预测工作,部分数据如下图所示:
-
2、理论
在进行xgboost模型时,其涉及参数如下表所述:
参数 说明 参数值设置 提升器类型 构建模型的算法方式,通常使用树模型较多 gbtree:树模型,适用于大多数情况;
gblinear:线性模型,特征数量远大于样本量时可考虑使用;
dart:DART算法,数据集较大时可考虑,但会增加过拟合风险学习器数量 用于构建的树的数量 默认是100 学习率 模型参数更新步长,越小收敛越快,但迭代次数越多 其范围介于(0.0, 1.0] 默认0.1 树最大深度 树的深度越大,则对数据的拟合程度越高(过拟合程度也越高) 默认是6 样本采样率 训练每棵树时所使用的样本的比例 其范围介于(0.0, 1.0],默认1.0 特征采样率 训练每棵树时所使用的特征的比例 其范围介于(0.0, 1.0],默认1.0 最小子节点权重 树的每个叶子节点上的所有样本的权重和最小值 其范围介于[0.0, +∞],默认1.0 分裂收益阈值 用来比较每次节点分裂带来的收益,效控制节点的过度分裂 其范围介于[0.0, +∞],默认0.0 L1正则化 通过在目标函数中添加L1范数的惩罚来防止过拟合。较大的alpha值会导致模型的权重更加稀疏,从而有助于进行特征选择 其范围介于[0.0, +∞],默认0.0 L2正则化 通过在目标函数中添加 L2 范数的惩罚来防止过拟合。较大的lambda值会导致模型的权重更加缩小,从而有助于防止过拟合。 其范围介于[0.0, +∞],默认1.0 任务类型 包括自动判断,分类和回归任务 系统会结合Y的不同数字个数自动判断分类或回归任务,当然可自行选择分类或回归任务 除此之外,与其它的机器学习算法类似,SPSSAU提供训练集比例参数(默认是训练集占0.8,测试集占0.2),数据归一化参数(默认不进行),以及保存预测值(Xgboost时会生成预测类别,但不会生成预测概率),保存训练测试标识(生成一个标题来标识训练集和测试集数据的标识)。
-
3、操作
本例子操作截图如下:
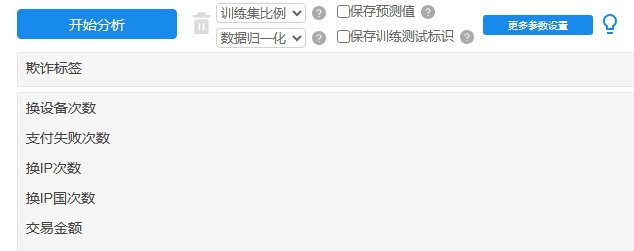
将欺诈标签放入Y框中,其余5个特征项作为自变量X。与此同时,训练集比例默认为0.8,暂不进行数据归一化,当然当前数据也可考虑做标准化处理,因为涉及数据的量纲不同。更多参数设置暂保持为默认值。
SPSSAU还提供“输出SHAP解释”选项,其位于“保存预测值”“保存训练测试标识”选项下方,默认不勾选。若希望进一步了解模型预测结果的形成原因,可勾选该项后再点击“开始分析”,此时结果页最后会额外输出“SHAP可解释性分析”板块,用于说明各个特征X对模型预测的影响大小及方向(具体见“4、SPSSAU输出结果”);不勾选则不输出该板块,模型本身的各项结果不受影响。
-
4、SPSSAU输出结果
SPSSAU共输出5项结果,依次为基本信息汇总,特征权重值,训练集或测试集模型评估结果,测试集结果混淆矩阵,模型汇总表和模型代码,如下说明:
项 说明 基本信息汇总 因变量Y(标签项)的数据分布情况等 特征权重值 展示各个X(特征)对于模型的贡献力度 训练集或测试集模型评估结果 分析训练集和测试集数据的模型效果评估,非常重要 测试集结果混淆矩阵 测试集数据的进一步效果评估,非常重要。分类任务时提供,如果是回归任务则没有该矩阵。 模型汇总表 模型参数及评估汇总表格 模型代码 模型构建的核心python代码 上述表格中,基本信息汇总展示出因变量Y(标签项)的分类分布情况,模型评估结果(包括训练集或测试集)用于模型的拟合效果判断,尤其是测试集的拟合效果,以及提供测试集数据的混淆矩阵结果(如果是分类任务则提供,如果是回归任务则无该表格);模型汇总表格将各类参数值进行汇总,并且在最后附录模型构建的核心代码。
若勾选了“输出SHAP解释”,结果页最后还会额外输出“SHAP可解释性分析”板块。该板块首先给出解释器类型、参与解释的样本数和特征数等说明信息,随后依次输出以下图表,每张图下方均附带对应的分析建议,可直接参考撰写分析报告:
图表 说明 全局特征重要性 条形图。将各特征按“平均|SHAP|值”从大到小排序,柱上直接标出数值。数值越大表示该特征X对模型输出的整体影响越大,可理解为模型层面的特征重要性,常用于特征筛选。 SHAP摘要图(蜂群图) 每个点代表一个样本。横轴为该样本的SHAP值,颜色表示该特征的取值高低(红色为高、蓝色为低)。可同时看出特征影响的大小、方向以及不同取值样本的分布情况。默认最多展示10个特征,其余特征合并为“其余N个特征合计”。 单样本SHAP瀑布图 从基准值E[f(X)]出发,逐个特征的贡献值累加,最终得到该样本的预测值f(x);红色表示推高预测值,蓝色表示拉低预测值。默认展示贡献绝对值最大的6项,其余合并为“其余N项”,适合逐步查看某一条样本的预测形成过程。 SHAP依赖图 横轴为所选特征的取值,纵轴为该特征对应的SHAP值,用于展示“特征取值→贡献大小”的变化关系;点的颜色表示与它相关性最强的另一特征;图底部灰色直方图表示该特征在样本中的取值分布。 单样本力图 以某一条样本的预测值f(x)为中心,展示每个特征将其推高(higher,红色)或拉低(lower,蓝色)的情况,适合快速查看单条样本的主要预测原因。 多样本力图 所有参与解释的样本按预测值从低到高排列,每一行代表一个样本,展示各特征推高或拉低的累计过程,可用于对比不同样本之间的差异。 SHAP热图 行为特征(默认最多10行,其余特征合并为一行),列为样本(按预测值排序),颜色表示SHAP值的大小;右侧黑色条为该特征的平均|SHAP|值,顶部折线为各样本的预测值f(x)。 图表上方的控制条
每张图上方各自带有控制条,用于切换该图的展示口径:
(1)样本(带“?”号):仅出现在单样本瀑布图和单样本力图上,下拉选择需要解释的样本,选项括号内为该样本的预测值f(x),首次默认选中预测值处于中位数的样本;点击“?”可查看样本编号含义、预测值含义和抽样情况。
(2)依赖图特征:仅出现在SHAP依赖图上,用于下拉选择依赖图横轴的特征,默认选中全局重要性最高的特征。
(3)输出类别:分类任务且输出类别数为2类及以上时出现(如本案例因变量Y为“欺诈/不欺诈”两个类别),切换后所有图表按所选类别重新计算并绘制,一次只展示一个输出类别;回归任务没有该控制条。
样本编号、预测值与抽样情况
样本编号:指原始数据表中的行号(第N行),可回到数据表中直接定位该条记录;若结果中未提供原始行号,则显示的是参与解释样本的顺序号,不能直接对应数据表中的行。
预测值:分类任务时,预测值为该样本对当前输出类别的原始得分(log-odds / 决策边际),不是概率值,得分越高越倾向判为该类别,越低(或为负)越不倾向;它是相对得分,未经Softmax换算成百分比。回归任务时,预测值与因变量同量纲。无论分类还是回归,均满足“预测值f(x)=基准值+ΣSHAP值”。
抽样情况:测试集样本可能较多,为兼顾计算速度与图表清晰度,SPSSAU会对参与解释的样本进行抽样(通常为百条量级)。提示框会说明测试集共有多少条样本、本次展示其中多少条;所有图表和数值均基于这批被展示的样本计算。
-
5、文字分析
首先针对特征的权重即重要性情况进行说明,如下图:
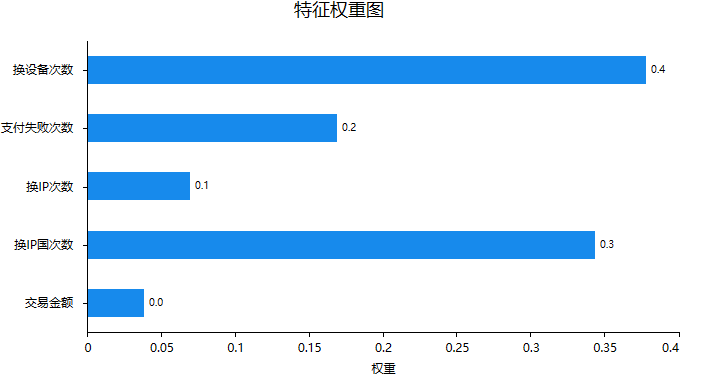
上图可以看到:换设备次数,或者换IP国次数这两项对于预测是否欺诈有着较高的帮助,而且支付失败次数也起着重要的作用。但是换IP次数或者交易金额这两项并不能很好地证明是否存在着欺诈行为。接下来针对最重要的模型拟合情况进行说明,如下表格:
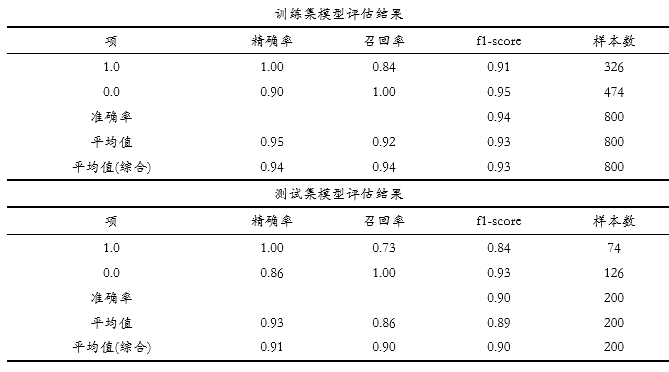
上表格中分别针对训练集和测试集,提供四个评估指标,分别是精确率、召回率、f1-scrore、准确率,以及平均指标和样本量指标等,整体来看,模型效果较差,因为无论是训练集还是测试集,F1-score值均训于0.9,其它指标比如精确率或者召回率指标,均高于0.9,整体上意味着模型构建较优。
接着进一步查看测试数据的‘混淆矩阵’,即模型预测和事实情况的交叉集合,如下图:
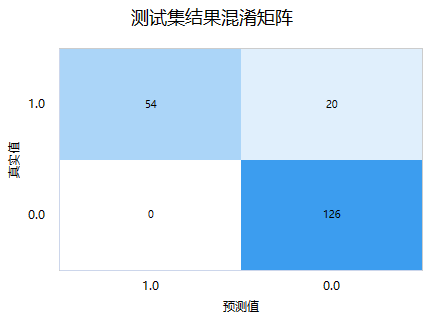
‘混淆矩阵’时,右下三角对角线的值越大越好,其表示预测值和真实值完全一致。上图中显示测试集时,真实值为1(即欺诈)但预测为0(即不欺诈)的数量为20,其余均预测正确,仅测试集共有200条,但预测出错为20条,出错率为10%。最后SPSSAU输出模型参数信息值,如下表格:
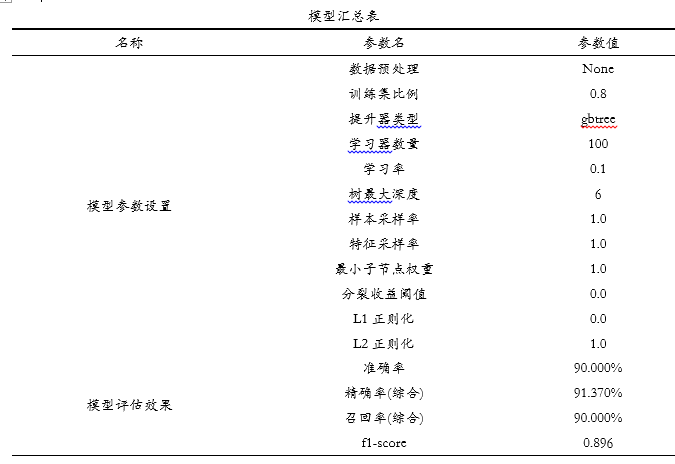
模型汇总表展示模型各项参数设置情况,最后SPSSAU输出使用python中slearn包构建本次xgboost模型的核心代码如下:
model = xgb.XGBClassifier(booster='gbtree', n_estimators=100, eta=0.1, max_depth=6, subsample=1.0, colsample_bytree=1.0, min_child_weight=1.0, gamma=0.0, lambda=1.0, alpha=0.0')
model.fit(x_train, y_train)
如果勾选了“输出SHAP解释”,SPSSAU还会在结果页最后输出SHAP可解释性分析图表,用于说明模型为什么给出这样的预测。以下按图表顺序进行说明(本案例因变量Y为“欺诈/不欺诈”2个类别,以下图表均针对当前选中的输出类别绘制,可通过图上方“输出类别”下拉框切换):
(1)全局特征重要性
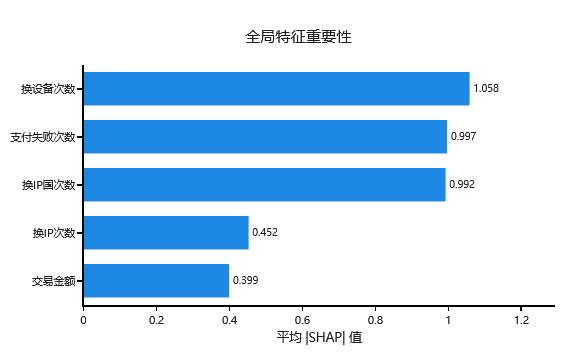
上图将各特征按平均|SHAP|值从大到小排序,并在柱形末端标注具体数值。本案例中“换设备次数”的平均|SHAP|值最大(1.058),“支付失败次数”(0.997)和“换IP国家次数”(0.992)与之非常接近,说明这三个特征对模型输出的整体影响相当,是模型最主要的判断依据;其次是“换IP次数”(0.452),“交易金额”(0.399)最小。若需进行特征筛选,可优先保留重要性较高的特征。
(2)SHAP摘要图(蜂群图)
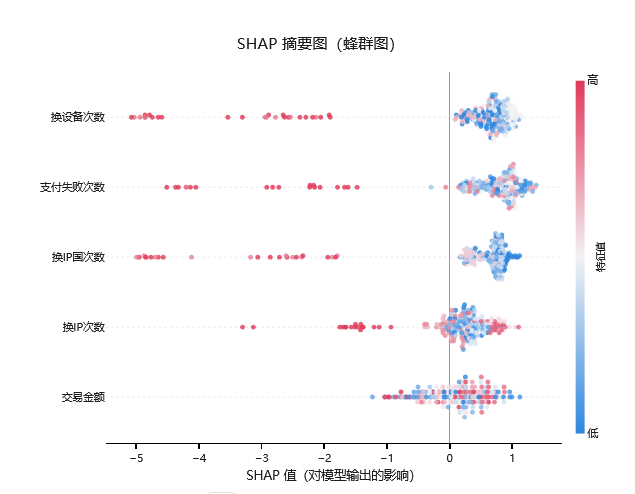
上图中每个点代表一个样本,横轴为该样本的SHAP值(点位于0右侧表示推高预测值,位于0左侧表示拉低),颜色表示该特征的取值高低(红色为高、蓝色为低)。以“换设备次数”为例,取值较高(红色)的样本集中在-5~-2一侧,取值较低(蓝色)的样本集中在0~1一侧,说明换设备次数越多,越拉低当前类别的预测;“支付失败次数”和“换IP国家次数”的形态与之类似,取值越高越偏负。“换IP次数”的红色点分别出现在负数一侧和正数一侧,方向不一致;“交易金额”的红蓝点交错分布在-0.5~1.5之间,方向不明显。当特征多于10个时,重要性较低的特征会合并为“其余N个特征合计”一行。
(3)单样本SHAP瀑布图
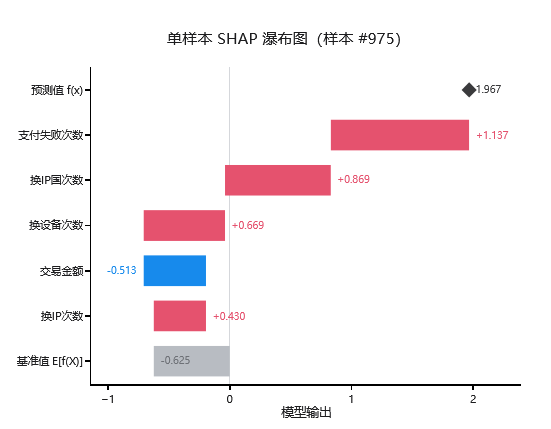
瀑布图用于展示某一条样本的预测值是如何由基准值逐项累加得到的。上图样本#975的基准值E[f(X)]为-0.625,“支付失败次数”(+1.137)、“换IP国家次数”(+0.869)、“换设备次数”(+0.669)和“换IP次数”(+0.430)为正向贡献,“交易金额”(-0.513)为负向贡献,各项累加后最终预测值f(x)为1.967。红色表示推高、蓝色表示拉低,数值为各特征的SHAP值;本案例特征仅5个,全部单独展示(特征较多时默认展示贡献绝对值最大的6项,其余合并为“其余N项”)。可通过图上方“样本”下拉框查看其它样本。
(4)SHAP依赖图
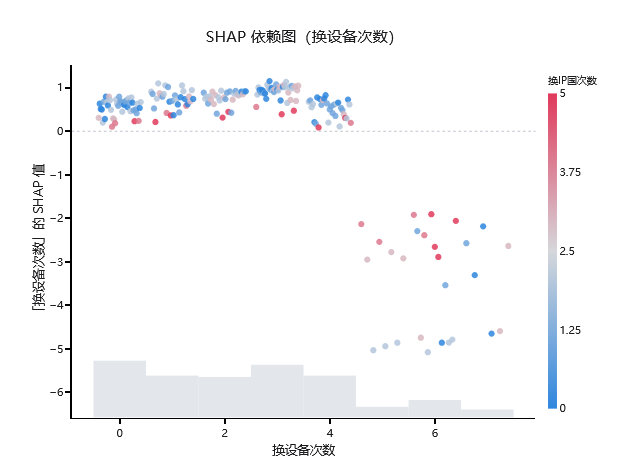
依赖图用于查看单个特征的取值与其贡献之间的关系。上图横轴为“换设备次数”的取值,纵轴为其SHAP值:换设备次数在0~4时SHAP值约为+0.2~+1.0,对当前类别的预测起推高作用;到4~5时骤降至-2~-5,5~7时维持在-2~-5.5区间,说明换设备次数超过一定水平后转为明显拉低预测,转折特征十分突出。点的颜色表示与“换设备次数”相关性最强的特征,本示例为“换IP国家次数”,颜色与SHAP值之间的规律不明显;图底部灰色直方图为“换设备次数”的取值分布,样本主要集中在0~4,4.5~6为次峰,6~7.5的样本很少。可通过图上方“依赖图特征”下拉框切换其它特征。
(5)单样本力图
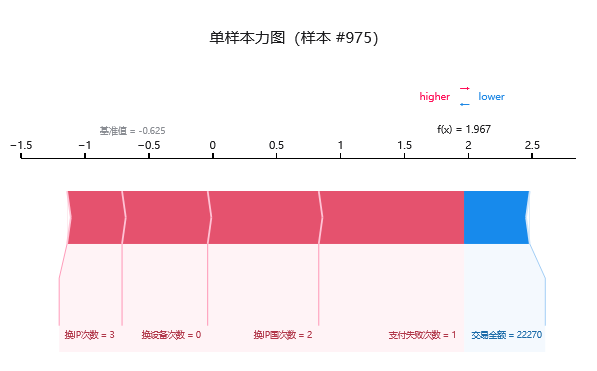
力图为同一条样本的另一种展示方式,以预测值f(x)为中心,红色(higher)表示将预测值推高的特征,蓝色(lower)表示拉低的特征,各特征按影响大小排列;图中同时标出基准值和预测值。本示例样本#975的预测值f(x)为1.967、基准值为-0.625,推高作用由强到弱依次为“支付失败次数”(+1.137)、“换IP国家次数”(+0.869)、“换设备次数”(+0.669)和“换IP次数”(+0.430),仅“交易金额”(取值22270)为拉低作用(-0.513);标签中同时给出了各特征的取值,换设备次数为0、支付失败次数为1、换IP国家次数为2、换IP次数为3。
(6)多样本力图
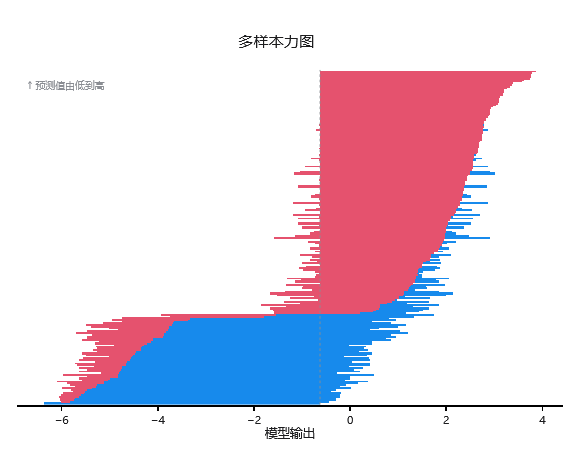
多样本力图将所有参与解释的样本按预测值从低到高(自下而上)排列,每一行代表一个样本,红色和蓝色分别表示各特征推高或拉低预测值的情况,灰色虚线为基准值(-0.625),本图各样本的预测值约在-6至4之间。预测值较低的样本以蓝色(拉低)为主,预测值较高的样本红色区域更长,说明有更多特征在推高预测。通过该图可对比不同样本的预测差异。
(7)SHAP热图
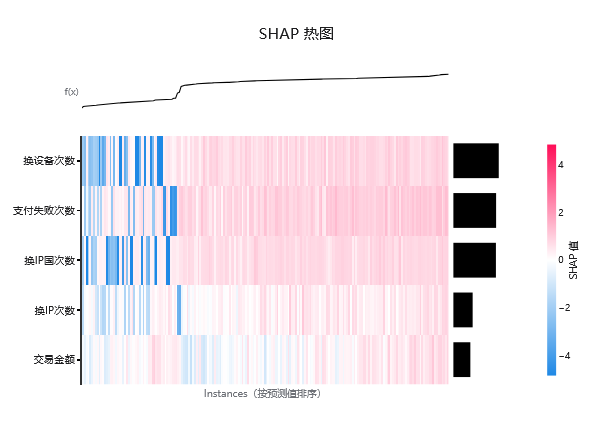
热图的行为特征,列为样本(按预测值从低到高排序),颜色表示SHAP值的大小(红色为正、蓝色为负,本图色阶约-4至+4);右侧黑色条为该特征的平均|SHAP|值,黑色条越长表示该特征在模型层面的重要性越高,本图中从上到下依次为“换设备次数”“支付失败次数”“换IP国家次数”“换IP次数”“交易金额”,与全局特征重要性的排序一致;顶部黑色折线为各样本的预测值f(x),从左到右逐渐升高。从图中可以看出,前三个特征所在行的颜色变化最明显,而“换IP次数”和“交易金额”两行颜色大多接近0(白色),区分作用相对较弱。
-
6、剖析
涉及以下几个关键点,分别如下:
-
保存预测值
-
保存预测值时,SPSSAU会新生成一个标题用于存储模型预测的类别信息,其数字的意义与模型中标签项(因变量Y)的数字保持一致意义。但xgboost(以及决策树/随机森林)不会生成类别的预测概率。
-
SPSSAU进行Xgboost模型构建时,自变量X(特征项)中包括定类数据如何处理?
-
logistic回归模型时通常不会关注于数据类型本身,如果一定要处理,建议可对定类数据进行哑变量转化后放入,关于哑变量可点击查看。
-
SPSSAU中Xgboost回归模型合格的判断标准是什么?
-
机器学习模型中,通常均为先使用训练数据训练模型,然后使用测试数据测试模型效果。通常判断标准为训练模型具有良好的拟合效果,同时测试模型也有良好的拟合效果。机器学习模型中很容易出现‘过拟合’现象即假的好结果,因而一定需要重点关注测试数据的拟合效果。针对单一模型,可通过变换参数调优,与此同时,可使用多种机器学习模型,比如使用决策树、随机森林、支持向量机、神经网络等,综合对比选择最优模型。
-
SPSSAU机器学习如何进行预测?
-
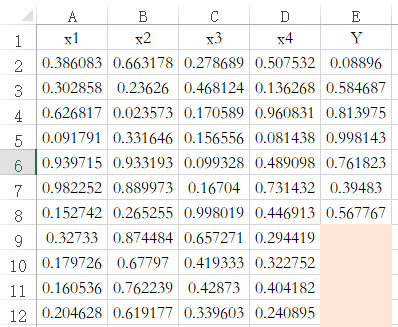
SPSSAU中默认带有数据预测功能,当特征项X有完整数据,但标签项(因变量Y)没有数据时,此时‘保存预测值’,SPSSAU会默认对此种情况进行预测。如下图中的编号9到12共4行数据,其只有X没有Y,那么保存预测值时,默认对该4行数据进行预测。机器学习的各方法(包括决策树/随机森林/KNN/贝叶斯/支持向量机/神经网络/logistic回归/Xgboost等)均遵从此规则。
-
-
如何将多个模型绘制ROC曲线对比优劣?
-
如果涉及多个模型预测能力绘制ROC曲线,用于多个模型预测能力对比。建议按以下步骤进行:
-
第1步是得到各个模型(比如神经网络模型、随机森林模型、logistic回归、Xgboost等)的预测值标题,该预测值可通过SPSSAU中‘保存预测值’参数选中后得到;
-
第2步是将得到的预测类别作为ROC曲线时的‘检验变量X’。此时绘制出来的ROC曲线则会有多条,分别表示各模型的预测值。与此同时,ROC曲线时的‘状态变量Y’为实际真实情况上的Y数据,并且该数据正常情况下为二分类(即仅包括2个数字即两个类别)。
-
【提示:比如决策树/随机森林/xgboost没有预测概率只有预测类别,此时则纳入预测类别。但比如神经网络/logistic回归可纳入预测概率或者预测类别均可】
-
机器学习算法时保存数据集标识的意思是什么?
-
选择‘保存数据集标识’后,SPSSAU会新生成一个标题,用于标识模型构建时训练集或测试集,使用数字1表示训练集,数字2表示测试集。如果后续分析时(比如绘制ROC曲线)只针对训练集,那么使用筛选样本功能,筛选出训练集后分析即可。
-
机器学习算法中保存预测信息具体是什么意思?
-
如果选中保存预测信息,并且为分类任务时,SPSSAU会新生成预测类别,预测类别是指最终预测出来Y的类别,预测类别标题名称类似为‘xgboost_Prediction_probability_****’,以及xgboost(以及决策树和随机森林)不会得到每个类别的预测概率。
-
为什么没有输出AUC指标及ROC曲线?
-
如果是分类任务并且为二分类(Y为分类数据且为二分类,且参数上默认或者选择为分类任务),此时SPSSAU默认会输出ROC曲线及AUC指标等。如果是多分类(Y为分类数据且大于两类,且为分类任务),此时AUC指标的意义较小暂未输出,如果有需要,可按下述步骤进行。
-
第1步:构建模型时先‘保存预测信息’,得到多个标题,每个标题对应1个类别时的预测概率;
-
第2步:将某个类别(即1个标题)的预测概率作为X,Y为模型构建时的Y,并且ROC曲线时分割点设置为放入的类别项对应的数字;
-
第3步:多个类别则重复进行多次,即得到每个Y类别标签的ROC曲线和AUC值等。
-
【提示:决策树、随机森林和Xgboost进行分类任务时只会得到预测类别,并不会得到预测概率,因而均不输出AUC或ROC曲线,当然研究者也可利用预测类别进行绘制ROC曲线,研究者自行处理即可】
-
SPSSAU机器学习‘交叉验证’?
-
SPSSAU机器学习中提供交叉验证功能,默认该参数为不进行,即默认不进行交叉验证。研究者可下拉选择比如5折或者10折交叉验证等。交叉验证是针对训练集数据进行,以及其运行时间可能相对较长。
-
SHAP解释的使用注意事项有哪些?
-
(1)勾选“输出SHAP解释”后,计算量和运行时间会有所增加,数据量较大或模型较复杂(如神经网络、支持向量机、集成模型等)时更为明显。
-
(2)SHAP是“事后解释”,只用于解释已经建好的模型,不会改变模型本身的拟合效果、参数和预测结果,不勾选时模型结果与原来完全一致。
-
(3)SHAP解释的是“模型”,而非“因果关系”:某特征SHAP值较大,只说明模型在预测时较依赖该特征,不能直接等同于该特征对结果存在因果影响。
-
(4)分类任务时SHAP值有正负之分,正负表示相对基准值的推拉方向;多个输出类别分别计算,各类别的SHAP值之间不存在“加总为1”的关系。
-
(5)样本编号旁的“?”号内容会根据实际结果自动变化(如是否提供原始行号、是否抽样等),请以实际提示为准。
-
疑难解惑
-
SHAP可解释性分析是什么,有什么作用?
-
SHAP(SHapley Additive exPlanations)基于合作博弈论中的Shapley值思想,把某一条样本的模型预测值f(x)拆分为“基准值+各特征贡献值”,即:f(x) = 基准值E[f(X)] + SHAP(X1) + SHAP(X2) + … + SHAP(Xk)。
其中,基准值E[f(X)]可理解为所有样本的平均预测水平;某个特征的SHAP值为正,表示该特征的取值将预测值“往上推”(更倾向该输出类别),为负表示“往下拉”;绝对值越大,说明该特征对这一条样本的影响越大。将某特征所有样本的SHAP值取绝对值后求平均(即“平均|SHAP|值”),就是该特征在模型层面的重要性。
因此,勾选“输出SHAP解释”后,SPSSAU既能给出模型整体的特征重要性排序,也能给出单条样本的预测原因,可弥补决策树、随机森林、神经网络等模型“只给预测结果、不给解释”的不足,适用于分类任务和回归任务(关联规则apriori除外)。
