K近邻KNN模型
-
案例数据下载 下载
K近邻KNN(k-nearest neighbor)是一种简单易懂的机器学习算法,其原理是找出挨着自己最近的K个邻居,并且根据邻居的类别来确定自己的类别情况。比如K为5个,即找出挨着自己最近的5个邻居,5个邻居中有4个是‘富人’,那么自己也会被标签为‘富人’。此处涉及几个点,一是距离如何计算,二是K值如何选择,三是如何归类。接下来案例部分将具体进行说明。
除此之外,K近邻KNN模型与Kmeans有些类似,二者目的都是分类,但Kmeans是事先不知道数据如何分类,KNN事先已经知道如何分类,二者有时候可以匹配着使用,比如先使用kmeans得到聚类类别,然后使用KNN模型分析聚类效果情况等。
K近邻KNN模型案例
-
1、背景
K近邻模型依旧经典的‘鸢尾花分类数据集’进行案例演示,其数据集为150个样本,包括4个特征属性(4个自变量X),标签为鸢尾花卉类别,其分为3个类别分别是刚毛鸢尾花、变色鸢尾花和弗吉尼亚鸢尾花(下称A、B、C三类)。
-
2、理论
K近邻KNN模型的原理上示意如下图:
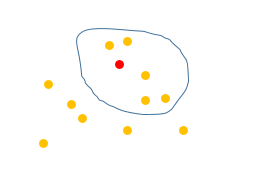
比如红色点,挨着其最近的5个点(K=5时)如上图,如果该5个点中多数均为A类,那么红色点就归为A类。需要注意的是,通常情况下K值为奇数,因为如果为偶数比如为6,那么3个为A类3个为B类,此时不好划分点的类别。
上述中关于挨的最近的距离,如何进行衡量呢?距离的计算方式非常多,比如欧式距离、曼哈顿距离等,通常情况下使用欧式距离,其计算公式如下:
比如有两行数据分别3列(即3个X,3个特征项),两行数据分别是(1,2,3)和(3,4,5),那么
另外关于K值的选择上,通常建议K介于3~20之间,且一般为奇数值,SPSSAU默认为5,如果说K值太大,容易出现‘过拟合’现象即结果看着很好但事实上不好;如果K值过小,容易出现拟合现象很糟糕(欠拟合)现象。实际使用时,可考虑分别设置不同的K值,然后对模型的优劣进行汇总和对比。
关于归类问题,上述比如K=5,挨的最近5个点中有3个(超过一半)为A类,那么该点就分为A类,此种分类方式为‘等比投票权’,即5个点的权重完全一致。但我们知道,挨的最近的5个点,其实都能计算出距离值,是否可根据距离值大小来加权判断呢?比如使用距离值的倒数,即1/距离值作为权重,如果距离值越大,权重就越小,并且综合计算来评估类别划分,此种方式叫‘距离反比投票权法’。关于类别划分参数,其叫‘样本投票权重’。
关于K近邻KNN模型时,通常涉及到以下参数值,如下:
参数 说明 参数值设置 邻近样本个数 K值,挨的最近邻居个数 默认5。可根据实际情况增减。 样本投票权重 两种分类依据方式 等比投票权:每个样本的投票权重一样;
距离反比投票权:样本距离的倒数作为权重,距离越近权重越高,反之越低。距离计算方法 用于计算样本点之间距离的方法 欧氏距离:默认,一般使用欧式距离即可。
曼哈顿距离:可选。邻近搜索方法 找出邻近K个值的时候使用的搜索方法。 全局搜索:蛮力实现,计算并搜索所有的样本点。
KD树:(KD tree)对训练集构造KD树,用KD树来搜索邻近样本点。
球树:(ball tree)对训练集构造球树,用球树来搜索邻近样本点。邻近样本个数K值,一般为奇数,并且常介于3~20之间,可设置不同的K值来对比不同模型的优劣。样本投票权重,默认是‘等比投票权’,可选为‘距离反比投票权’,建议K值较小时可考虑使用‘距离反比投票权’法。距离计算方法上,默认是欧式距离,可选曼哈顿距离,通常使用欧式距离即可。邻近搜索方法上,一种是全局搜索,比如100个样本,某个点分别先计算出该点离另外100个样本的距离,然后找出其中最小的K个,此种方式简单易懂,但是计算费资源,因而延伸出KD树和ball树两种优化算法。默认情况下系统会自动结合数据情况选择邻近搜索方法,研究者也可自行选择。
-
3、操作
本例子操作如下:
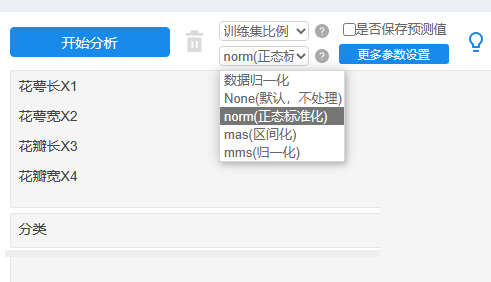
训练集比例默认选择为:0.8即80%(150*0.8=120个样本)进行训练K近邻KNN模型,余下20%即30个样本(测试数据)用于模型的验证。需要注意的是,多数情况下,会首先对数据进行标准化处理,处理方式一般使用为正态标准化,此处理目的是让数据保持一致性量纲。当然也可使用其它的量纲方式,比如区间化,归一化等。
接着对参数设置如下:
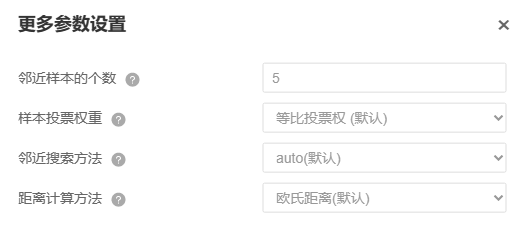
邻近样本个数K值默认为5,样本投票权重方式为‘等比投票权’,邻近搜索方法自动让系统选择,距离计算方式为‘欧氏距离’法。
SPSSAU还提供“输出SHAP解释”选项,其位于“保存预测值”“保存训练测试标识”选项下方,默认不勾选。若希望进一步了解模型预测结果的形成原因,可勾选该项后再点击“开始分析”,此时结果页最后会额外输出“SHAP可解释性分析”板块,用于说明各个特征X对模型预测的影响大小及方向(具体见“4、SPSSAU输出结果”);不勾选则不输出该板块,模型本身的各项结果不受影响。
-
4、SPSSAU输出结果
SPSSAU共输出5项结果,依次为基本信息汇总,训练集或测试集模型评估结果,测试集结果混淆矩阵,模型汇总表和模型代码,如下说明:
项 说明 基本信息汇总 因变量Y(标签项)分类数据分布情况等 训练集或测试集模型评估结果 分析训练集和测试集数据的模型效果评估,非常重要 测试集结果混淆矩阵 测试集数据的进一步效果评估,非常重要 模型汇总表 模型参数及评估汇总表格 模型代码 模型构建的核心python代码 上述表格中,基本信息汇总表格展示因变量Y的分类数据分布情况,接着展示训练集和测试集效果情况,并且单独提供测试集数据混淆判断矩阵,进一步分析测试数据的正确效果等,模型汇总表格展示整体模型参数情况,并且提供sklean进行KNN模型构建的核心代码。
若勾选了“输出SHAP解释”,结果页最后还会额外输出“SHAP可解释性分析”板块。该板块首先给出解释器类型、参与解释的样本数和特征数等说明信息,随后依次输出以下图表,每张图下方均附带对应的分析建议,可直接参考撰写分析报告:
图表 说明 全局特征重要性 条形图。将各特征按“平均|SHAP|值”从大到小排序,柱上直接标出数值。数值越大表示该特征X对模型输出的整体影响越大,可理解为模型层面的特征重要性,常用于特征筛选。 SHAP摘要图(蜂群图) 每个点代表一个样本。横轴为该样本的SHAP值,颜色表示该特征的取值高低(红色为高、蓝色为低)。可同时看出特征影响的大小、方向以及不同取值样本的分布情况。默认最多展示10个特征,其余特征合并为“其余N个特征合计”。 单样本SHAP瀑布图 从基准值E[f(X)]出发,逐个特征的贡献值累加,最终得到该样本的预测值f(x);红色表示推高预测值,蓝色表示拉低预测值。默认展示贡献绝对值最大的6项,其余合并为“其余N项”,适合逐步查看某一条样本的预测形成过程。 SHAP依赖图 横轴为所选特征的取值,纵轴为该特征对应的SHAP值,用于展示“特征取值→贡献大小”的变化关系;点的颜色表示与它相关性最强的另一特征;图底部灰色直方图表示该特征在样本中的取值分布。 单样本力图 以某一条样本的预测值f(x)为中心,展示每个特征将其推高(higher,红色)或拉低(lower,蓝色)的情况,适合快速查看单条样本的主要预测原因。 多样本力图 所有参与解释的样本按预测值从低到高排列,每一行代表一个样本,展示各特征推高或拉低的累计过程,可用于对比不同样本之间的差异。 SHAP热图 行为特征(默认最多10行,其余特征合并为一行),列为样本(按预测值排序),颜色表示SHAP值的大小;右侧黑色条为该特征的平均|SHAP|值,顶部折线为各样本的预测值f(x)。 图表上方的控制条
每张图上方各自带有控制条,用于切换该图的展示口径:
(1)样本(带“?”号):仅出现在单样本瀑布图和单样本力图上,下拉选择需要解释的样本,选项括号内为该样本的预测值f(x),首次默认选中预测值处于中位数的样本;点击“?”可查看样本编号含义、预测值含义和抽样情况。
(2)依赖图特征:仅出现在SHAP依赖图上,用于下拉选择依赖图横轴的特征,默认选中全局重要性最高的特征。
(3)输出类别:分类任务且输出类别数为2类及以上时出现(如本案例因变量Y共A、B、C三个类别),切换后所有图表按所选类别重新计算并绘制,一次只展示一个输出类别;回归任务没有该控制条。
样本编号、预测值与抽样情况
样本编号:指原始数据表中的行号(第N行),可回到数据表中直接定位该条记录;若结果中未提供原始行号,则显示的是参与解释样本的顺序号,不能直接对应数据表中的行。
预测值:分类任务时,预测值为该样本对当前输出类别的原始得分(log-odds / 决策边际),不是概率值,得分越高越倾向判为该类别,越低(或为负)越不倾向;它是相对得分,未经Softmax换算成百分比。回归任务时,预测值与因变量同量纲。无论分类还是回归,均满足“预测值f(x)=基准值+ΣSHAP值”。
抽样情况:测试集样本可能较多,为兼顾计算速度与图表清晰度,SPSSAU会对参与解释的样本进行抽样(通常为百条量级)。提示框会说明测试集共有多少条样本、本次展示其中多少条;所有图表和数值均基于这批被展示的样本计算。
-
5、文字分析
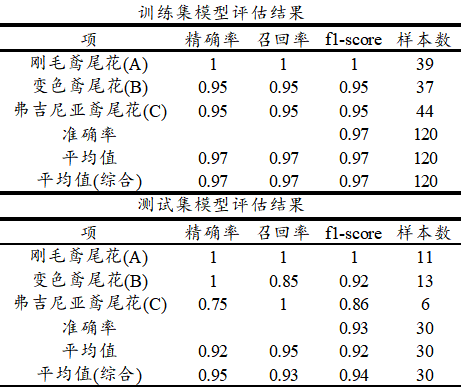
上表格中分别针对训练集和测试集,提供四个评估指标,分别是精确率、召回率、f1-scrore、准确率,以及平均指标和样本量指标等,如下表格说明:
项 说明 精确率 比如:预测为A类时,事实上是A类的比例,越大越好 召回率 比如:事实上是A类时,预测为A类的比例,越大越好 F1-score 精确率和召回率的调和平均数,越大越好,一般使用此指标较多 准确率 整体上全部数据预测准确的比例情况,越大越好,仅1个数字 平均值 对应指标的平均值,越大越好 平均值(综合) 对应指标的加权平均值(考虑样本量情况下) 样本量 各类别的样本量情况 一般来说,f1-score指标值最适合,因为其综合精确率和召回率两个指标,并且可查看其平均值(综合)指标,本案例为0.97,并且测试数据的表现上为0.94,意味着评估效果好,当前的KNN模型(基于K值为5时)表现良好。当然也可以更新K值个数,比如设置为7,重新运行结果并且对比选择最优模型。事实上当前设置K=7时,训练集的f1-scroe由0.97上升到0.98有点提升,但这并不重要,因为当K值更大时,理论上模型就会变的更好,反倒训练集时太好了反倒有‘过拟合’现象,因而应该更多关注于测试集数据,测试集数据的f1-score值为0.94,说明测试集表现基本一致(测试集数据的拟合表现非常关键)。
进一步地,可查看测试数据的‘混淆矩阵’,即模型预测和事实情况的交叉集合,如下图:
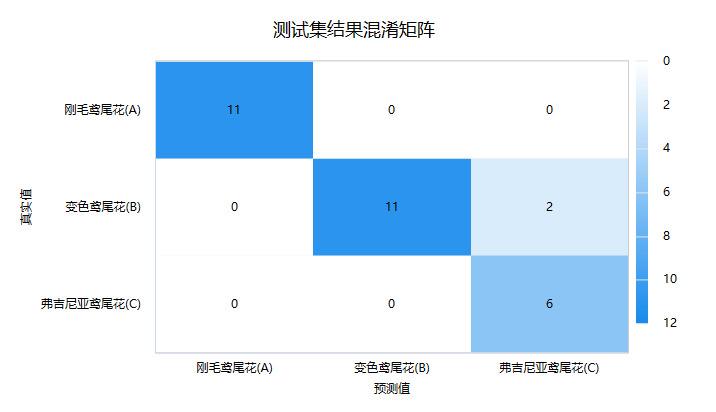
‘混淆矩阵’时,右下三角对角线的值越大越好,其表示预测值和真实值完全一致。上图中B类时有2个测试数据被预测为C类,错误率较低。
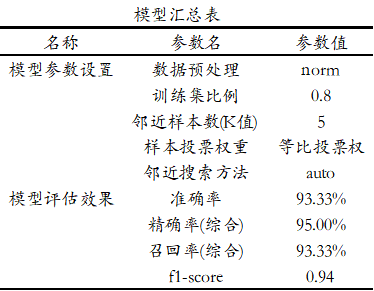
最后针对模型汇总表,其展示构建K近邻KNN的各项参数设置,包括针对数据进行标准化正态处理,参数值为norm,训练集占比和K值设置等。最后,SPSSAU输出使用python中slearn包构建本次K近邻KNN模型的核心代码如下:
model = KNeighborsClassifier(n_neighbors=5, weights=uniform, algorithm=auto, p=2)
model.fit(x_train, y_train)
如果勾选了“输出SHAP解释”,SPSSAU还会在结果页最后输出SHAP可解释性分析图表,用于说明模型为什么给出这样的预测。以下按图表顺序进行说明(本案例因变量Y共3个类别,以下图表均针对当前选中的输出类别绘制,可通过图上方“输出类别”下拉框切换):
(1)全局特征重要性
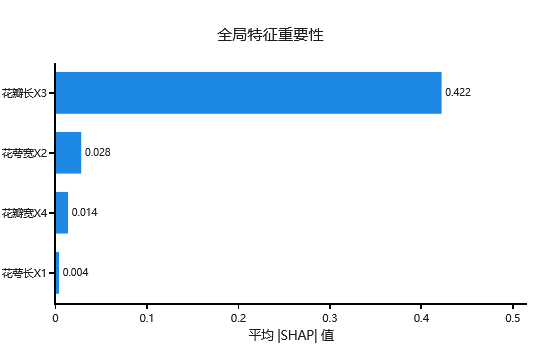
上图将各特征按平均|SHAP|值从大到小排序,并在柱形末端标注具体数值。本案例中“花瓣长X3”的平均|SHAP|值最大(0.422),明显高于其它特征,说明其对模型输出的整体影响最大;其次是“花萼宽X2”(0.028)和“花瓣宽X4”(0.014);“花萼长X1”最小(0.004)。若需进行特征筛选,可优先保留重要性较高的特征。
(2)SHAP摘要图(蜂群图)
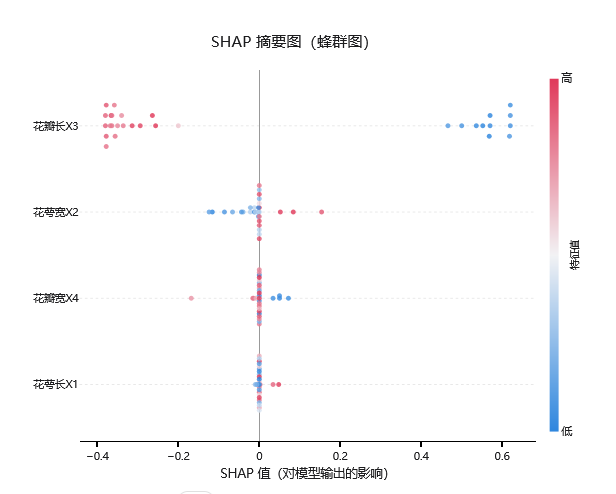
上图中每个点代表一个样本,横轴为该样本的SHAP值(点位于0右侧表示推高预测值,位于0左侧表示拉低),颜色表示该特征的取值高低(红色为高、蓝色为低)。以“花瓣长X3”为例,取值较高(红色)的样本集中在0左侧(约-0.40~-0.25),取值较低(蓝色)的样本分布在0右侧(约0.15~0.65),说明花瓣长越长越拉低当前类别的预测;而“花萼宽X2”取值越高(红色)越推高当前类别的预测;其余两个特征的点大多贴近0,影响较小。当特征多于10个时,重要性较低的特征会合并为“其余N个特征合计”一行。
(3)单样本SHAP瀑布图
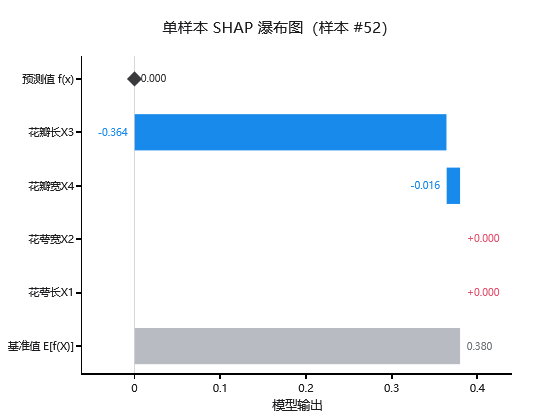
瀑布图用于展示某一条样本的预测值是如何由基准值逐项累加得到的。上图样本#52的基准值E[f(X)]为0.380,由“花瓣长X3”(-0.364)大幅拉低、“花瓣宽X4”(-0.016)小幅拉低,“花萼宽X2”和“花萼长X1”的贡献约为0,最终预测值f(x)为0.000。红色表示推高、蓝色表示拉低,数值为各特征的SHAP值;本案例特征仅4个,全部单独展示(特征较多时默认展示贡献绝对值最大的6项,其余合并为“其余N项”)。可通过图上方“样本”下拉框查看其它样本。
(4)SHAP依赖图
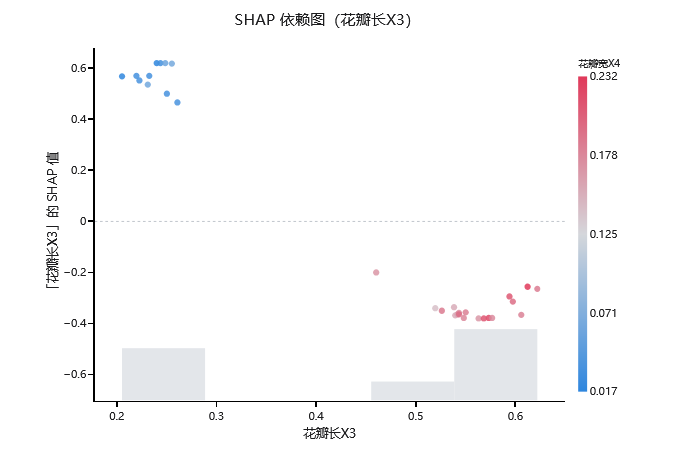
依赖图用于查看单个特征的取值与其贡献之间的关系。上图横轴为“花瓣长X3”的取值,纵轴为其SHAP值:花瓣长在0.20~0.29时SHAP值为正(约+0.45~+0.62),对当前类别的预测起推高作用;在0.46~0.62时SHAP值转为负(约-0.20~-0.40),且花瓣长越大SHAP值越负,整体与SHAP值呈明显负相关。点的颜色表示与“花瓣长X3”相关性最强的特征,本示例为“花瓣宽X4”,花瓣长较大的一组花瓣宽也较高(红色);图底部灰色直方图为“花瓣长X3”在样本中的取值分布,样本主要集中在0.20~0.29、0.46~0.54和0.54~0.62三个区间。可通过图上方“依赖图特征”下拉框切换其它特征。
(5)单样本力图
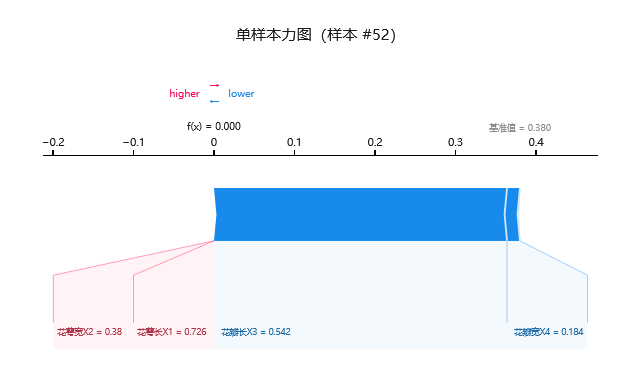
力图为同一条样本的另一种展示方式,以预测值f(x)为中心,红色(higher)表示将预测值推高的特征,蓝色(lower)表示拉低的特征,各特征按影响大小排列;图中同时标出基准值和预测值。本示例样本#52的预测值f(x)为0.000、基准值为0.380,“花瓣长X3”(取值0.542)为主要拉低因素,“花瓣宽X4”(取值0.184)小幅拉低,花萼宽X2、花萼长X1的贡献接近0;标签中同时给出了各特征的取值,花萼长X1为0.726、花萼宽X2为0.38。
(6)多样本力图
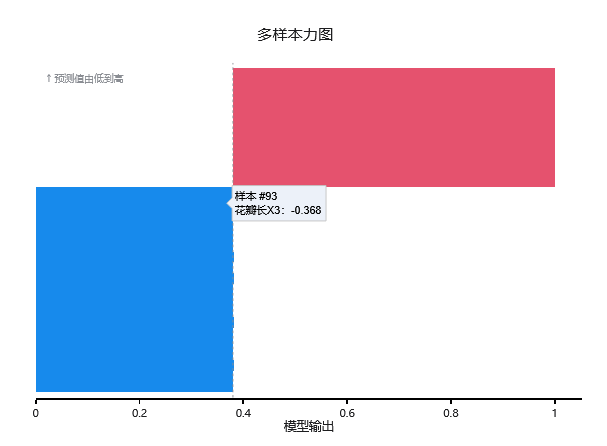
多样本力图将所有参与解释的样本按预测值从低到高(自下而上)排列,每一行代表一个样本,红色和蓝色分别表示各特征推高或拉低预测值的情况,灰色虚线为基准值(0.380)。预测值较低的样本以蓝色为主(由0延伸至约0.38),高于基准值的样本以红色为主(由约0.38延伸至1.0)。通过该图可对比不同样本的预测差异。
(7)SHAP热图
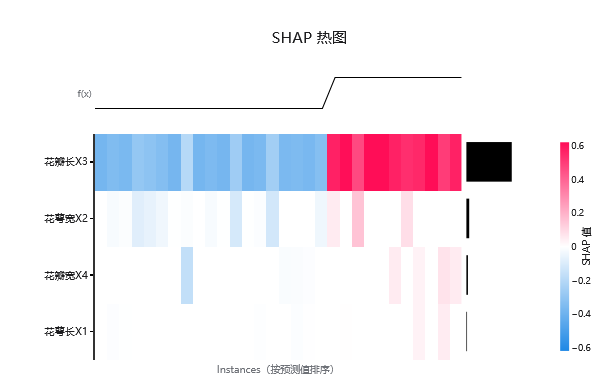
热图的行为特征,列为样本(按预测值从低到高排序),颜色表示SHAP值的大小(红色为正、蓝色为负,本图色阶约-0.6至+0.6);右侧黑色条为该特征的平均|SHAP|值,黑色条越长表示该特征在模型层面的重要性越高,本图中“花瓣长X3”的黑色条明显最长,与全局特征重要性的排序一致;顶部黑色折线为各样本的预测值f(x),从左到右逐渐升高。从图中可以看出,只有“花瓣长X3”一行颜色变化明显,其余三行颜色大多接近0(白色),说明本案例中模型对不同样本的区分几乎完全由花瓣长决定。
-
6、剖析
涉及以下几个关键点,分别如下:
-
K近邻KNN模型时是否需要标准化处理?
-
一般建议是进行标准化处理,通常使用正态标准化处理方式即可,当然也可使用比如归一化处理等,其目的是处理特征的单位量纲问题,试想身高为1.8与体重为50公斤,这单位不同计算距离时会有严重影响。
-
训练集比例应该选择多少?
-
如果数据量很大,比如1万,那么训练集比例可以较高比如0.9,如果数据量较小,此时训练集比例选择较小预留出较多数据进行测试即可。
-
保存预测值
-
保存预测值时,SPSSAU会新生成一个标题用于存储模型预测的类别信息,其数字的意义与模型中标签项(因变量Y)的数字保持一致意义。
-
SPSSAU进行K近邻KNN模型构建时,自变量X(特征项)中包括定类数据如何处理?
-
K近邻KNN模型时,如果有定类数据,建议对其哑变量处理后放入,关于哑变量可 点击查看。
-
SHAP解释的使用注意事项有哪些?
-
(1)勾选“输出SHAP解释”后,计算量和运行时间会有所增加,数据量较大或模型较复杂(如神经网络、支持向量机、集成模型等)时更为明显。
-
(2)SHAP是“事后解释”,只用于解释已经建好的模型,不会改变模型本身的拟合效果、参数和预测结果,不勾选时模型结果与原来完全一致。
-
(3)SHAP解释的是“模型”,而非“因果关系”:某特征SHAP值较大,只说明模型在预测时较依赖该特征,不能直接等同于该特征对结果存在因果影响。
-
(4)分类任务时SHAP值有正负之分,正负表示相对基准值的推拉方向;多个输出类别分别计算,各类别的SHAP值之间不存在“加总为1”的关系。
-
(5)样本编号旁的“?”号内容会根据实际结果自动变化(如是否提供原始行号、是否抽样等),请以实际提示为准。
-
疑难解惑
-
SHAP可解释性分析是什么,有什么作用?
-
SHAP(SHapley Additive exPlanations)基于合作博弈论中的Shapley值思想,把某一条样本的模型预测值f(x)拆分为“基准值+各特征贡献值”,即:f(x) = 基准值E[f(X)] + SHAP(X1) + SHAP(X2) + … + SHAP(Xk)。
其中,基准值E[f(X)]可理解为所有样本的平均预测水平;某个特征的SHAP值为正,表示该特征的取值将预测值“往上推”(更倾向该输出类别),为负表示“往下拉”;绝对值越大,说明该特征对这一条样本的影响越大。将某特征所有样本的SHAP值取绝对值后求平均(即“平均|SHAP|值”),就是该特征在模型层面的重要性。
因此,勾选“输出SHAP解释”后,SPSSAU既能给出模型整体的特征重要性排序,也能给出单条样本的预测原因,可弥补决策树、随机森林、神经网络等模型“只给预测结果、不给解释”的不足,适用于分类任务和回归任务(关联规则apriori除外)。
-
SPSSAU机器学习如何进行预测?
-
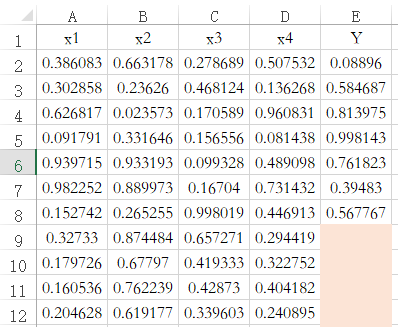
SPSSAU中默认带有数据预测功能,当特征项X有完整数据,但标签项(因变量Y)没有数据时,此时‘保存预测值’,SPSSAU会默认对此种情况进行预测。如下图中的编号9到12共4行数据,其只有X没有Y,那么保存预测值时,默认对该4行数据进行预测。机器学习的各方法(包括决策树/随机森林/KNN/贝叶斯/支持向量机和神经网络等)均遵从此规则。
-
SPSSAU机器学习中量纲归一化处理的具体规则情况?
-
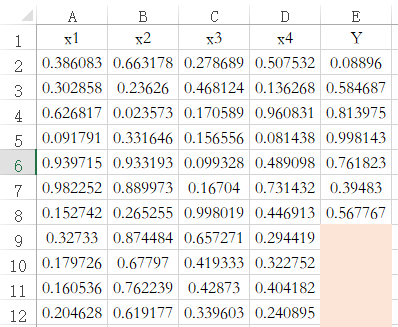
SPSSAU中,机器学习时均具有归一化参数值,并提供正态标准化/区间化/归一化等方式。其原理是针对具有完整数据的特征项X分别进行处理。比如下图中是针对编号为2~12共计11项的4个X分别进行处理。
-
机器学习中分类任务和回归任务的区别是什么?
-
机器学习包括分类任务和回归任务,当标签项(因变量Y)为类别数据时,其为分类任务,比如研究X对于“贷款是否逾期”的预测作用,“是否逾期”这个分类数据,因而此时此为分类任务。如果因变量Y为定量数据,比如研究X对于“贷款金额”的预测作用,“贷款金额”为定量数据,因而为回归任务。决策树/随机森林/支持向量机和神经网络等时,SPSSAU默认会对因变量Y进行识别,并且自动选择分类任务或者回归任务。当然研究者可以在“更多参数设置”处进行选择设置。另外,KNN和贝叶斯这两项仅提供分类任务。
-
机器学习时提示‘分类数据必须为整数’?
-
机器学习包括分类任务和回归任务,如果是定量数据Y进行分类任务,此时系统会提示“分类数据必须为整数”。决策树/随机森林/支持向量机和神经网络等时,可通过“更多参数设置”处进行选择设置,以及KNN和贝叶斯这两项仅提供分类任务。
-
机器学习算法时保存数据集标识的意思是什么?
-
选择‘保存数据集标识’后,SPSSAU会新生成一个标题,用于标识模型构建时训练集或测试集,使用数字1表示训练集,数字2表示测试集。如果后续分析时(比如绘制ROC曲线)只针对训练集,那么使用筛选样本功能,筛选出训练集后分析即可。
-
如何将多个机器学习模型数据绘制ROC曲线?
-
如果有多个机器学习模型后,需要对比模型优劣情况。建议按下述步骤进行。
-
第1步:每个机器学习模型最后一次构建后,选中‘保存预测信息’,系统会生成类别的预测概率;
-
第2步:将多个机器学习模型的某类别的预测概率值一并纳入作为X,以及将Y作为Y,进行ROC曲线【注意,放入的是某个类别的预测概率值】;
-
第3步:设置ROC曲线时对应的分割点,需要注意的是,分割点一定要设置为放入的对应类别时预测概率值对应的数字。
-
需要提示的是:预测概率是指某类别的预测概率值,二分类时只有两个数字,比如是和否(数字1和数字0表示),那么‘是’对应的预测概率值即为模型预测出‘是’的概率,‘是’和‘否’的概率加和一定为1。
-
机器学习算法中保存预测信息具体是什么意思?
-
如果选中保存预测信息,并且为分类任务时,SPSSAU会新生成两项标题,分别是预测类别和预测概率。预测类别是指最终预测出来Y的类别,预测概率是指预测出Y的每个类别对应的概率情况;事实上某个类别的预测概率相对最大时,此时预测类别就为该类别(比如Y有A/B/C共3个类别,某样本时3个类别的预测概率分别是0.4,0.5,0.1),那么预测类别则为B类别。
-
预测类别标题名称类似为‘NeutralNetwork_Prediction_****’,以及预测属于每个类别概率标题名类似‘NeutralNetwork_Prediction_probability_****’。
-
保存预测信息后,可进一步使用预测概率进行其它的分析或者处理,比如绘制ROC曲线等。
-
SPSSAU机器学习‘交叉验证’?
-
SPSSAU机器学习中提供交叉验证功能,默认该参数为不进行,即默认不进行交叉验证。研究者可下拉选择比如5折或者10折交叉验证等。交叉验证是针对训练集数据进行,以及其运行时间可能相对较长。
